vLLM 核心技術簡介:PagedAttention、Continuous Batching、Prefix Caching
前言
久違的學習筆記來了!會有這篇文主要是我前陣子看了這個影片:大模型推理引擎 vLLM 是什麼?為什麼同一張 GPU 可以承載數倍請求?,覺得還蠻有趣的,就順手把我跟 AI 對話的學習筆記請 AI 整理後貼上來。有興趣的人也可以直接看影片,我覺得還蠻淺顯易懂的。
Disclaimer: 以下為我與 AI 對話的學習筆記,由 AI 重點整理,再由我進行校對與格式編輯。
vLLM 核心技術簡介
為什麼需要 vLLM
LLM 上線服務時,真正的瓶頸往往不是算力,而是兩件事:
- 記憶體浪費:每個請求的 KV cache 又大又會動態成長,傳統做法造成大量碎片。
- GPU 空轉:同一批請求要等最慢的跑完,先結束的只能閒置。
vLLM 的三大核心技術分別對症下藥:PagedAttention(解決記憶體)、Continuous Batching(解決空轉)、Prefix Caching(省掉重複計算)。

請求先進佇列,由排程器每一步重新挑選;KV cache 的 block 由 PagedAttention 管理,Prefix Caching 讓相同前綴的 block 被重用。
先備知識:KV Cache
自回歸生成時,每產生一個 token,都要用到前面所有 token 的 Key 和 Value。由於 causal attention 的特性,前面 token 的 K/V 一旦算出就不會再改變,所以可以存起來重用,這就是 KV cache(關於什麼是 Key 和 Value,可以去搜尋 Attention is All You Need 這篇論文或關於 Transformer 的介紹)。
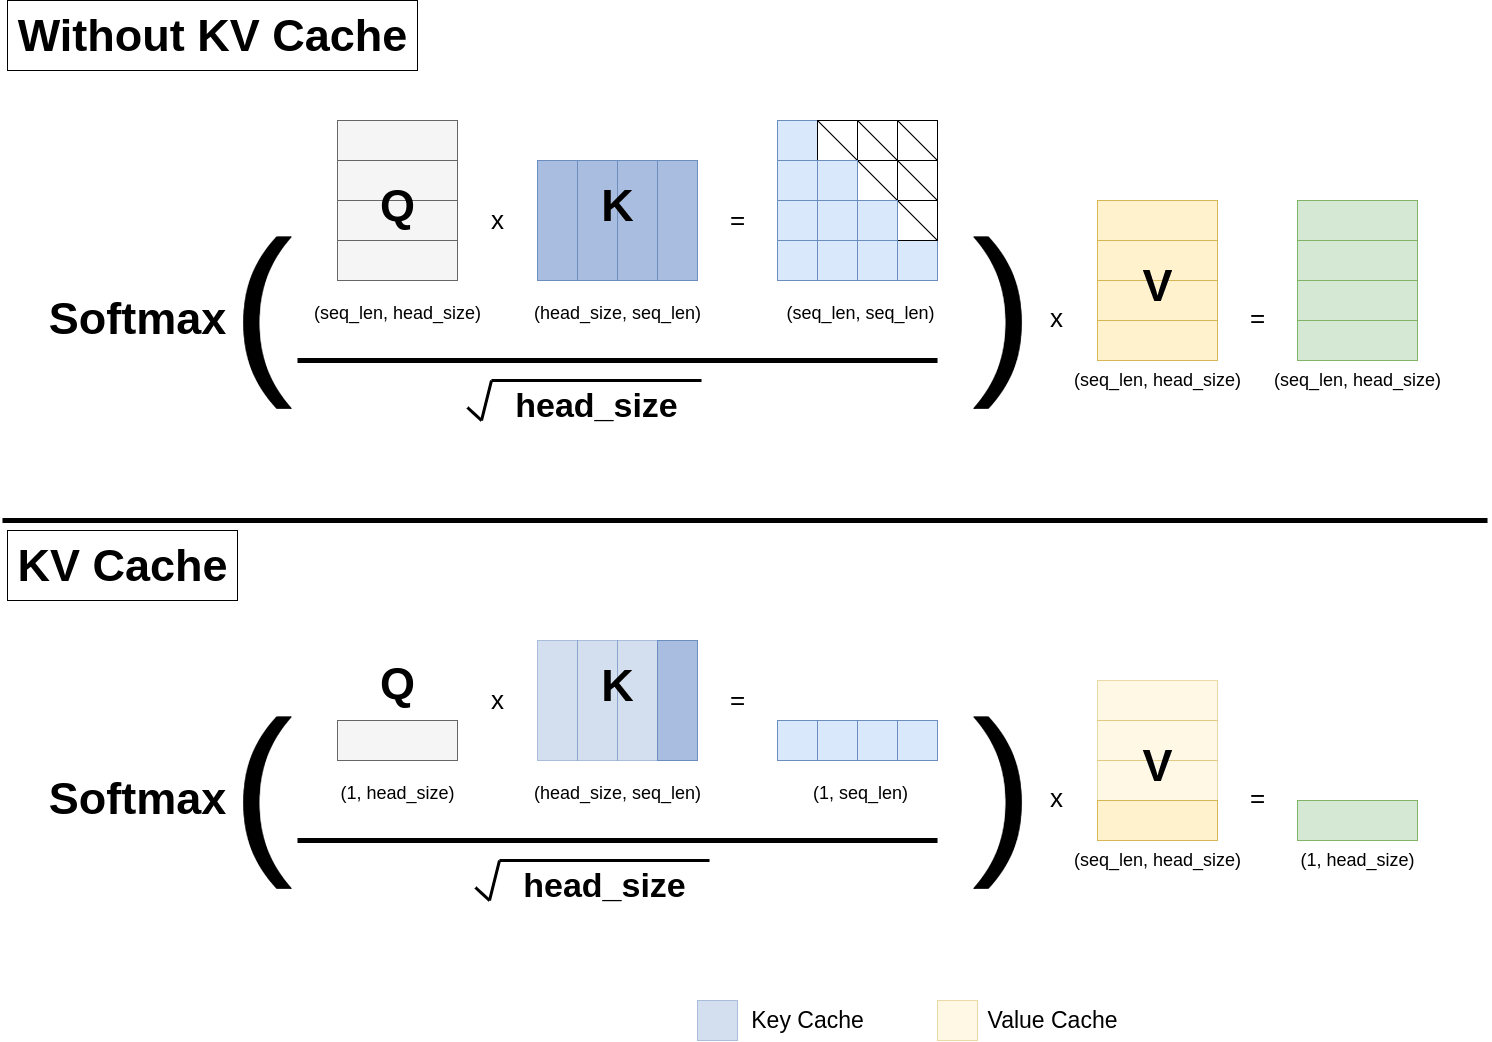
Source:KV Cache: 一種加速 Transformer 模型生成速度的暫存機制,關於更多 KV Cache 的介紹也可以看這篇。
傳統做法是為每個請求預先配置一塊「連續」記憶體,而且因為不知道回答會多長,只能照最大長度預留。結果是:
- 內部碎片:預留了用不到的空間。
- 外部碎片:大小不一的記憶體塊之間留下空隙。
原論文指出,現有系統的 KV cache 記憶體有 60–80% 被浪費,直接限制了能同時處理的請求數。
PagedAttention:用分頁管理 KV cache
核心想法借自作業系統的虛擬記憶體:
- 把 KV cache 切成固定大小的 block(例如每塊存 16 個 token)。
- block 在實體記憶體中不需要連續。
- 用一張「block table」(頁表)記錄每個請求的邏輯區塊對應到哪些實體區塊。
- 需要時才分配新區塊,請求結束就回收。

請求 A 的三個邏輯區塊,透過 block table 對到實體記憶體中不相鄰的位置;中間夾著別的請求的區塊也沒關係。圖中的區塊編號僅為示意。
類比:舊方法像是每個人先租下一整排書架,怕書變多;新方法是每人只拿一格小櫃子,書多了再加一格,櫃子不必相鄰。
兩層實作
- 記憶體管理層:分塊、頁表、分配與回收。
- Attention kernel:KV 不再連續,計算時要透過頁表「跳著讀」,所以需要專門改寫的 CUDA kernel。
要強調的是,PagedAttention 不改變 attention 的數學,算出的結果與一般 attention 完全一致,改變的只是 KV 的存放與讀取方式。它專門管理 KV cache(不是模型權重),也只對自回歸生成有意義;像 BERT 這種 encoder-only 模型沒有動態成長的 KV cache,就用不到。
帶來的好處
- 幾乎消除碎片,記憶體浪費降到接近零。
- 能同時處理更多請求,論文報告吞吐量提升 2–4 倍。
- 區塊共享:多個回答共用同一段 prompt、beam search 共用前綴時,只在內容分歧時才複製(copy-on-write)。
Block 的大小怎麼決定
分成兩個層面。
1. 一個 block 存幾個 token(可設定):用 --block-size 設定,vLLM 預設常見值是 16。部分 attention backend 對可用值有限制。
2. 一個 block 佔多少位元組(由模型決定):
1 | block 大小 = 2 × block_size × num_layers × num_kv_heads × head_dim × 每元素位元組數 |
其中 2 代表 K 和 V 各一份;用 GQA/MQA 的模型 num_kv_heads 會小很多;FP16 每元素 2 bytes,FP8 為 1 byte。
以 Llama-2-7B(FP16、block_size=16、32 層、32 個 KV head、head_dim 128)為例:
1 | 2 × 16 × 32 × 32 × 128 × 2 bytes ≈ 8 MB |
也就是每個 token 約 0.5 MB。
| 小 block | 大 block | |
|---|---|---|
| 內部碎片 | 少 | 多 |
| 頁表/管理開銷 | 大 | 小 |
| GPU 讀取效率 | 較差(更常跳著讀) | 較好 |
| Prefix cache 命中 | 粒度細,較易命中 | 粒度粗,需整塊相同 |
16 是在這些因素間的折衷。總 block 數則是「可用於 KV 的記憶體 ÷ 每個 block 的位元組數」,所以模型越大、層數越多、用 FP16 而非 FP8,能放的 block 就越少。
KV cache 什麼時候可以被覆蓋
KV cache 並不是「聰明地判斷哪些重要」,而是用請求生命週期 + 引用計數 + LRU 這些簡單規則管理。
| 情況 | 能不能覆蓋 |
|---|---|
| 請求進行中 | 不行 |
| 請求結束,無 prefix caching | 立刻釋放 |
| 請求結束,有 prefix caching | 先保留,依 LRU 淘汰 |
| 記憶體不足 | 搶佔(preemption):重算(recompute)或換到 CPU(swap) |
| 滑動視窗模型(如 Mistral) | 視窗外的 KV 可丟棄 |
Continuous Batching:每一步都重新排程
傳統的 static batching 中,一批請求一起進、一起出。輸出長度不同,先結束的請求只能空等最長的那個,GPU 在空轉。
Continuous batching(又稱 iteration-level scheduling)把排程單位從「一整批請求」改成「每一步 token 生成」。每生成完一個 token,scheduler 就檢查一次:
- 有請求結束(遇到 EOS 或達長度上限)→ 立刻移出、釋放資源。
- 等待佇列有新請求 → 立刻補進空位。

上半部的短請求結束後,位置只能空著等最長的那個;下半部每一步都檢查,位置一空出來就補進等待中的新請求。圖中的長度僅為示意。為什麼可行?因為 LLM 是自回歸的,每一步 forward 本來就是獨立的一次運算,請求在 batch 裡只是「再多算一個 token」,可以在任何一步加入或離開。
與 PagedAttention 的關係
請求不斷進出,KV cache 的需求就忽大忽小;沒有分頁機制,很難有效率地分配與回收這些記憶體,也就難以做出實用的 continuous batching。兩者是互相搭配的設計。效果上,吞吐量大幅提升,新請求也不必等整批結束,延遲同時下降。
Prefix Caching:相同前綴只算一次
如果很多請求共用相同的前綴(system prompt、RAG 的固定文件、few-shot 範例),這段前綴的 KV 只要算過一次存起來,下次直接重用,就能省掉 prefill。
它佔用多少空間?
沒有固定配額。Prefix cache 不是另外劃一塊區域,而是和一般 KV cache 共用同一個 block pool。啟動時,vLLM 先量測載入權重與 activation 峰值後的剩餘記憶體,再依 --gpu-memory-utilization(預設 0.9)決定可用比例,剩下的全部切成 block。
block 有三種狀態:
- 使用中:有請求在用(reference count > 0),不能動。
- 空閒且無內容:隨時可分配。
- 空閒但保有快取內容:ref count = 0 但內容還留著,等待被重用。第三種就是 prefix cache 實際佔用的部分。

新請求先拿完全空的 block,不夠才依 LRU 淘汰「空閒但有快取」的 block;使用中的 block 永遠不會被動到。
cache 永遠讓位給活躍請求
新請求需要 block 時,先拿完全空的;不夠就依 LRU 踢掉「空閒但有快取」的 block。因此:
- 負載低時,空閒 block 多,cache 命中率高。
- 負載高時,block 幾乎都被活躍請求佔住,cache 很快被淘汰,命中率下降。
想增加快取容量,可以調高 --gpu-memory-utilization、改用 FP8 KV cache 讓每個 block 變小(總 block 數變多),或增加 GPU。
附錄與延伸
vLLM 的其他重要技術
- Chunked Prefill:把長 prompt 的 prefill 切成小塊,和 decode 混在同一批,避免長 prefill 卡住其他請求,讓延遲更穩定。
- Speculative Decoding:用小模型(或 n-gram、Medusa、EAGLE 等方法)先猜幾個 token,再讓大模型一次驗證,猜對就一次前進多步。
- 量化:GPTQ、AWQ、FP8、INT8,減少權重與 KV cache 的記憶體佔用。
- 平行化:tensor parallelism、pipeline parallelism、expert parallelism(MoE)。
- 底層優化:CUDA graph、FlashAttention / FlashInfer、融合 kernel。
- 其他功能:Multi-LoRA serving、structured output(JSON schema / 文法限制)、disaggregated prefill/decode。
如果只挑最核心的三個:PagedAttention + Continuous Batching + Prefix Caching。
原論文涵蓋了什麼
原論文 Efficient Memory Management for Large Language Model Serving with PagedAttention(SOSP 2023)是 2023 年的版本,並未涵蓋所有上述概念。
有涵蓋:PagedAttention 與 block table(§4.1)、KV cache manager(§4.2)、記憶體碎片分析(§3)、copy-on-write 與 beam search(§4.4、§6.3)、preemption 的 swap/recompute(§4.5)、tensor parallelism(§4.6)、shared prefix(§6.4)、block size 的消融實驗(§7)。
僅簡單帶過或不在論文中:
- Continuous batching 承接自 Orca,論文只當背景介紹。
- 自動 prefix caching(hash 比對、reference count、LRU 淘汰)是後來才加入 vLLM 的實作。
- Chunked prefill、speculative decoding、量化、CUDA graph、Multi-LoRA、structured output 等,都是後續功能,需看官方文件或各自的論文。
- 本文中由模型參數推算 block 位元組數的公式,是依模型結構推導,並非出自論文。
延伸閱讀
- Efficient Memory Management for Large Language Model Serving with PagedAttention(vLLM 原論文)
- Runpod - vLLM Explained: PagedAttention and Continuous Batching
- LearnOpenCV - vLLM: Deploying LLMs at Scale
- PagedAttention: The KV Cache as Virtual Memory
- ZeroEntropy - vLLM Serving
- ZeroEntropy - Continuous Batching